
Statistiek - SPSS - wijze van berekening kolom "sig." in SPSS. Ik wens te achterhalen hoe de berekening verloopt om tot de waarden in kolom "sig" van SPSS package te komen? Ik vind iets van een betekenis, maar ik vind voorlopig nog niet de achterliggende rekenwijze.
Beste Wouter,
De kolom "sig" bij het statistische pakket SPSS is de tweezijdige p-waarde van de toetsstatistiek. Indien het om een toetsstatistiek gaat die alleen een eenzijdige p-waarde toelaat, geeft "sig" de eenzijdige p-waarde. De toetsstatistiek die gebruikt wordt staat in andere kolom meestal aangeduid door "t", "F" of het woord "statistic". Om de p-waarde te berekenen, moet je ook het aantal vrijheidsgraden kennen van de toetsstatistiek die in de kolom "df" wordt vermeld.
Een p-waarde wordt door een softwarepakket berekend. De gebruiker berekent deze p-waarde niet zelf maar hij kan er wel voor kiezen deze op te zoeken in een statistische tabel.
Om de werkwijze te illustreren geef ik even een voorbeeld uit mijn cursus "biostatistiek":
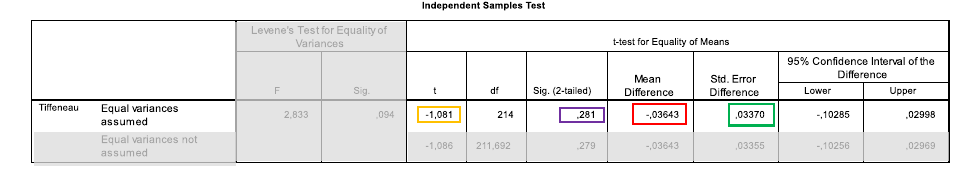
De aspecten die even minder belangrijk zijn, heb ik in bovenstaande tabel grijs gemaakt. In dit voorbeeld passen we de "student t-toets" toe. Deze wordt gebruikt om het gemiddelde van twee groepen te vergelijken op voorwaarde dat (1) de twee groepen onafhankelijk zijn, (2) wiens data een normale verdeling volgen en (3) de spreiding of standaarddeviatie van deze groepen voldoende gelijk zijn.
We zien in deze tabel enkele getallen verschijnen. De waarde van de t-toets is -1.081. Dit is de waarde van de toetsstatistiek. Deze wordt berekend door het gemiddelde verschil (rode waarde) te delen door haar standaardfout (groene waarde). Verder zien we de vrijheidsgraden in kolom df wat gelijk is aan 214. Dit is de totale steekproefgrootte - 2. In deze studie zijn er 216 COPD patiënten wiens Tiffeneau-index werd bepaald. Aangezien er 2 groepen zijn, is het totaal aantal vrijheidsgraden 214 of 216 - 2.
De p-waarde of significantie is de tweezijdige overschrijdingskans van de t-waarde. Die overschrijdingskans is een conditionele kans. Gegeven dat er geen verschil is tussen deze twee groepen, hoe waarschijnlijk is het dat er nog een groter verschil mogelijk is, dan het verschil (in dit voorbeeld -0.03643 in mean difference) wat we observeren. Hoe kleiner deze kans wordt, hoe belangrijker het verschil is wat geobserveerd wordt. Het is doorgaans gebruikelijk om de drempelwaarde op 5% te leggen. Als deze overschrijdingskans dus kleiner wordt dan 5%, beschouwen het geobserveerde verschil als een significante vaststelling.
Om deze p-waarde te berekenen, moet je eerst begrijpen wat een t-verdeling is. De t-verdeling is een kansverdeling die volgende vormen aanneemt:
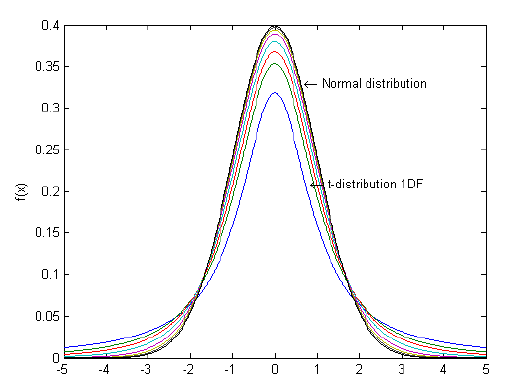
Hoe hoger het aantal vrijheidsgraden des te meer de t-verdeling zich gedraagt als een normale verdeling maar bij een laag aantal vrijheidsgraden heeft de t-verdeling dikkere staarten dan de normale verdeling.
Om de p-waarde te berekenen, berekenen we volgende oppervlakte onder de kromme:
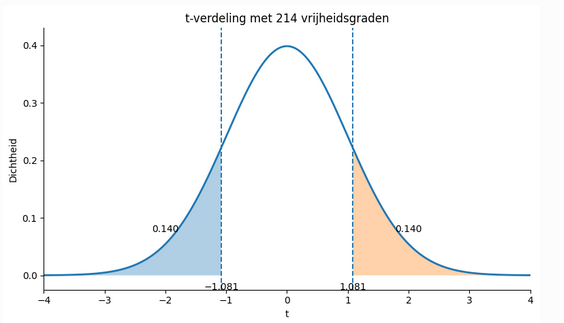
Deze oppervlakte onder de kromme bij t>1.081 en t<-1.081 is samen p = 0.28. Er zijn verschillende methoden om deze oppervlakte onder de kromme effectief uit te rekenen om tot 0.28 te komen. Het pakket SPSS gebruikt de geregulariseerde incomplete betafunctie (zie https://en.wikipedia.org/wiki/Beta_function) als volgt:
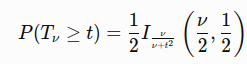
Hierbij is t=1.081 en v het aantal vrijheidsgraden 214. Deze formule geeft de oranje oppervlakte. Software gaat deze formule uitrekenen aan de hand van een voortgezette breuk tot een bepaalde precisie.
Vriendelijke groeten,
Kurt Barbé
Beste prof. dr. Barbé, Heel erg bedankt voor de inspanningen en tijd. Ik begrijp al een stukje van je antwoord. Dank, Wouter
Enkel de vraagsteller en de wetenschapper kunnen reageren op een antwoord.
(toegepaste) Wiskunde, statistiek, kansrekening, wetenschappelijk rekenen, wiskundig modelleren

© 2008-2026
Ik heb een vraag wordt gecoördineerd door Eos wetenschap. Voor vragen over het platform kan je terecht bij ikhebeenvraag@eos.be


